Meestal doe je niets. De normaliteitsaanname van een t-toets of ANOVA gaat niet over je ruwe waarnemingen maar over de verdeling van het gemiddelde, en die wordt bij voldoende grote steekproeven vanzelf normaal — ook als je data scheef zijn. Pas bij kleine groepen, extreme scheefheid of een ordinale uitkomst moet je echt iets anders doen.
Deze vraag komt bijna altijd op hetzelfde moment: je hebt je data binnen, je draait een normaliteitstoets, die is significant, en je concludeert dat je hele analyse niet mag. In de meeste gevallen klopt die conclusie niet. Hieronder wat de aanname wél zegt, hoe je hem beoordeelt en welke vier routes je hebt als hij echt geschonden is.
Waar gaat de normaliteitsaanname eigenlijk over?
Niet over je ruwe data. Dat is de kern van het misverstand.
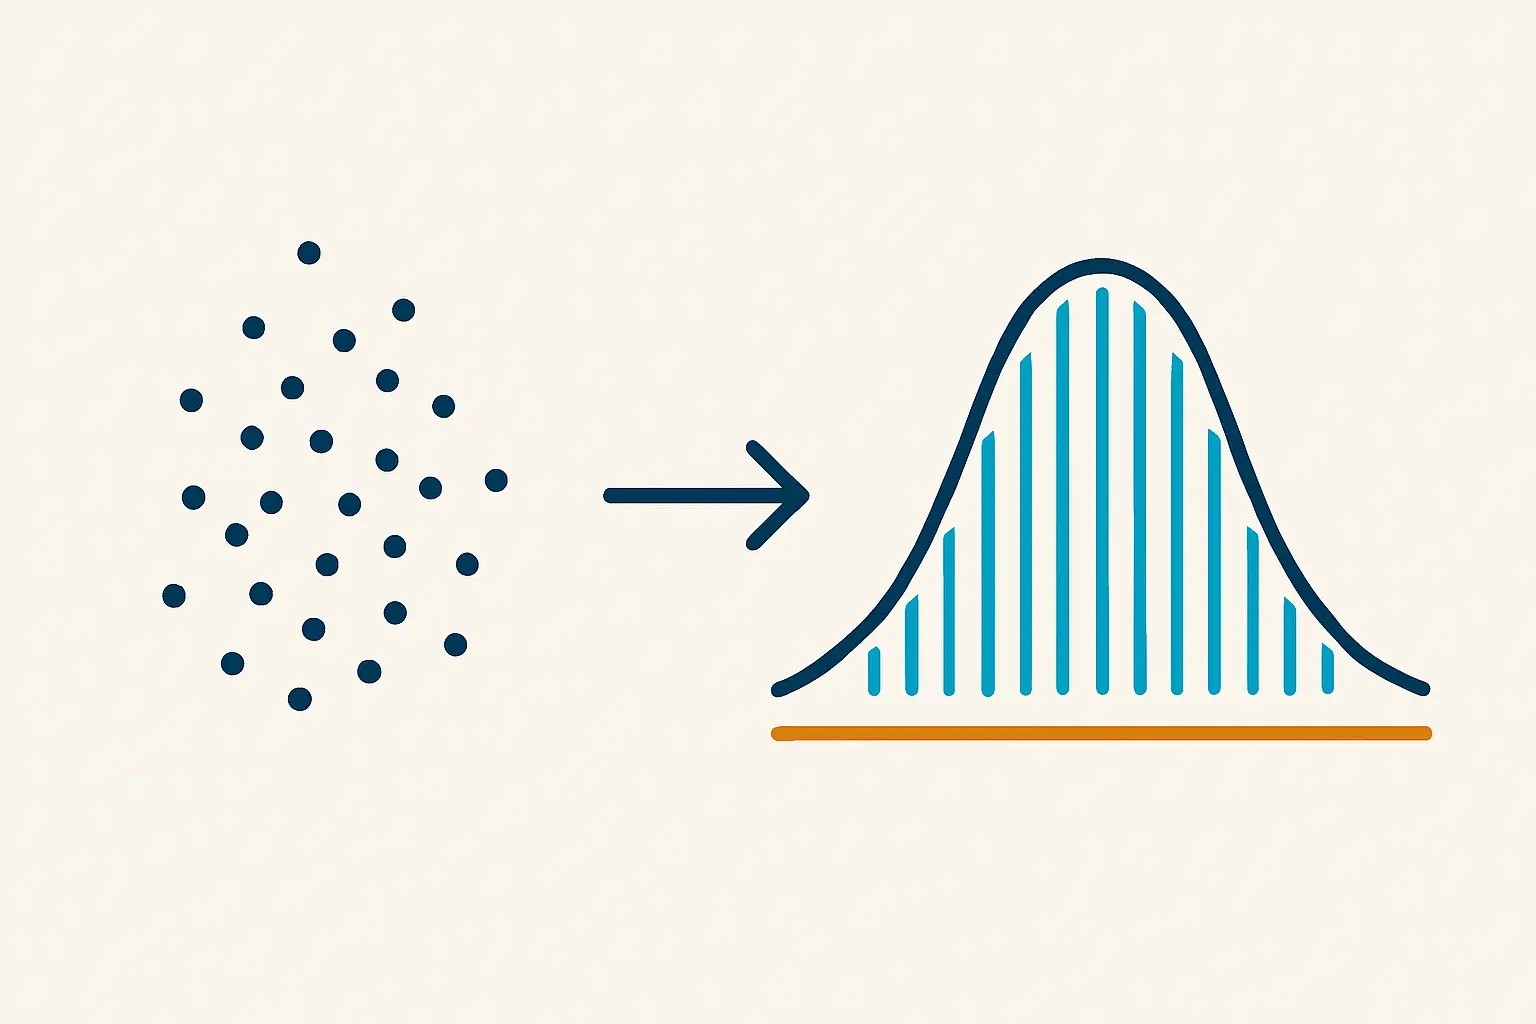
Bij een t-toets en een ANOVA gaat de aanname over de steekproefverdeling van het gemiddelde: de denkbeeldige verdeling die je zou krijgen als je je onderzoek heel vaak zou herhalen en telkens het gemiddelde opschreef. Bij een regressie gaat hij over de residuen — de afwijkingen tussen wat je model voorspelt en wat je hebt gemeten — en niet over de losse variabelen.
Dat verschil is beslissend, omdat de centrale limietstelling precies over die steekproefverdeling gaat. Scribbr formuleert hem zo: de centrale limietstelling “stelt dat de gemiddelden van steekproeven altijd normaal verdeeld zullen zijn als je steekproeven van voldoende omvang neemt uit een populatie, zelfs als die populatie niet normaal verdeeld is”. En verderop: de steekproefverdeling van het gemiddelde is normaal “mits de steekproefgrootte groot genoeg is. Het maakt hiervoor niet uit of de verdeling van de populatie normaal, Poisson, binomiaal of anders verdeeld is.”
Met andere woorden: een scheve verdeling in je eigen dataset is op zichzelf geen probleem. Je hebt een probleem als je steekproef te klein is om die stelling te laten werken.
Waarom is mijn normaliteitstoets dan significant?
Omdat een normaliteitstoets — Shapiro-Wilk of Kolmogorov-Smirnov — de vraag beantwoordt “is deze verdeling exact normaal?”, en het antwoord daarop is in de praktijk altijd nee. Echte data zijn nooit precies normaal.
Het gevolg is een test die zich tegengesteld gedraagt aan wat je wilt:
- Bij een kleine steekproef, waar de aanname er juist toe doet, heeft de toets weinig onderscheidend vermogen en komt hij vaak niet-significant uit. Je krijgt groen licht op het moment dat je het minst kunt vertrouwen.
- Bij een grote steekproef, waar de centrale limietstelling je allang beschermt, pikt de toets iedere minieme afwijking op en komt hij significant uit. Je krijgt rood licht op het moment dat het er nauwelijks toe doet.
Daarom is p < 0,05 bij Shapiro-Wilk geen bewijs dat je analyse ongeldig is. Het is één signaal, en meestal niet het belangrijkste.
Hoe beoordeel ik het dan wel?
Kijk ernaar in plaats van erop te toetsen. Drie dingen, in deze volgorde.
- Maak een histogram van de relevante variabele of van de residuen. Je zoekt geen perfecte klok, je zoekt of er iets grondig mis is: twee pieken, een harde afkap, alles opgehoopt tegen één rand.
- Maak een Q-Q-plot. Liggen de punten ongeveer op de diagonaal, dan zit je goed. Buigen de uiteinden systematisch weg, dan heb je zware staarten of scheefheid.
- Kijk naar scheefheid en gepiektheid als getal, maar behandel ze als beschrijving en niet als drempelwaarde. Ze vertellen je in welke richting de afwijking zit.
Rapporteer wat je zag, niet alleen wat de toets zei. “Het histogram toont een rechtsscheve verdeling; gezien de steekproefomvang van 180 is de t-toets desondanks toegepast” is een sterkere zin in je methodehoofdstuk dan “Shapiro-Wilk was niet significant, dus de aanname is voldaan”.
Wanneer moet ik dan wél iets anders doen?
Er zijn vier situaties waarin je de standaardtoets niet zomaar kunt doorzetten.
| Situatie | Waarom het uitmaakt | Wat je doet |
|---|---|---|
| Kleine groepen (ruwweg onder de 20 à 30 per groep) | De centrale limietstelling heeft te weinig waarnemingen om te werken | Non-parametrische toets, of een expliciete verantwoording |
| Extreme scheefheid of duidelijke uitbijters | Het gemiddelde beschrijft je groep niet meer | Mediaan rapporteren, non-parametrische toets |
| Ordinale uitkomst (bijvoorbeeld één losse Likert-vraag) | Het gemiddelde van “eens” en “oneens” heeft geen schaal | Non-parametrische toets, of een somscore van meerdere items |
| Tweetoppige verdeling | Je meet waarschijnlijk twee groepen in één | Zoek de verborgen variabele en splits |
Die laatste is de belangrijkste en wordt het vaakst gemist. Een verdeling met twee pieken is zelden een technisch probleem; het is een inhoudelijke aanwijzing dat er een groepsverschil in je data zit dat je nog niet hebt gemodelleerd.
Welke non-parametrische toets hoort bij welke situatie?
Non-parametrisch betekent dat de toets met rangordes werkt in plaats van met de waarden zelf. Daardoor doet de vorm van de verdeling er veel minder toe. Elke gangbare toets heeft een tegenhanger.
| Als je normaal zou doen | Non-parametrisch alternatief | Vergelijkt |
|---|---|---|
| Independent samples t-toets | Mann-Whitney U | Twee onafhankelijke groepen |
| Paired samples t-toets | Wilcoxon signed-rank | Twee metingen bij dezelfde personen |
| One-way ANOVA | Kruskal-Wallis | Drie of meer onafhankelijke groepen |
| Pearson-correlatie | Spearman-rangcorrelatie | Samenhang tussen twee variabelen |
Twee dingen om te weten voordat je overstapt. Ten eerste kosten deze toetsen wat onderscheidend vermogen: bij data die wél netjes zijn, vind je met een non-parametrische toets iets minder snel een effect. Ten tweede toetsen ze niet precies hetzelfde. Mann-Whitney vergelijkt geen gemiddelden maar de kans dat een willekeurige waarde uit de ene groep hoger is dan uit de andere. Schrijf je conclusie dus in die termen en niet als “de gemiddelden verschillen”.
Moet ik mijn data transformeren?
Dat kan, maar het is zelden de eerste keus in een scriptie. Een logaritmische of wortel-transformatie maakt een rechtsscheve verdeling symmetrischer, en bij variabelen als inkomen, wachttijd of aantal websitebezoeken is dat gebruikelijk in het vakgebied.
De prijs betaal je bij de interpretatie: na een log-transformatie is je uitkomst niet meer “euro’s” maar “log-euro’s”, en elke coëfficiënt moet je terugvertalen voordat iemand hem begrijpt. Doe het dus alleen als het in jouw vakgebied gangbaar is — check dat in de artikelen die je toch al leest — en leg in je methodehoofdstuk uit wat je hebt gedaan en waarom.
Wat je nooit doet: meerdere transformaties proberen en die kiezen waarbij je p-waarde onder de 0,05 duikt. Dat is geen assumptiecontrole meer.
En de aanname van gelijke varianties?
Die komt vaak in hetzelfde adem, en hier is het antwoord juist heel praktisch. De klassieke t-toets gaat ervan uit dat beide groepen ongeveer even veel spreiding hebben; Levene’s toets controleert dat.
Maar er bestaat een variant die die aanname helemaal niet nodig heeft — de Welch-t-toets — en die presteert bij gelijke varianties nauwelijks slechter. In veel programma’s is dit gewoon de tweede regel van je output (“equal variances not assumed”). Rapporteer die regel standaard en je hebt het probleem niet. Voor ANOVA bestaat een vergelijkbare Welch-variant.
Dit is het zeldzame geval waarin de assumptiediscussie met één klik verdwijnt in plaats van met een hoofdstuk verantwoording.
Hoe schrijf ik dit op in mijn methodehoofdstuk?
Kort, en in deze volgorde: wat je hebt gecontroleerd, wat je zag, welk besluit je nam en waarom. Drie tot vijf zinnen zijn genoeg.
Een bruikbaar model: “De verdeling van [variabele] is beoordeeld met een histogram en een Q-Q-plot. De verdeling was rechtsscheef. Gezien de steekproefomvang van [n] per groep is uitgegaan van de robuustheid van de t-toets tegen afwijkingen van normaliteit; ter controle is dezelfde vergelijking met een Mann-Whitney U-toets uitgevoerd, die tot dezelfde conclusie leidde.”
Die laatste zin is de sterkste zet die je hier kunt doen. Draai beide toetsen, en als ze hetzelfde zeggen, is de hele discussie beslecht — dan maakt het aantoonbaar niet uit welke aanname je maakt. Kosten: twee minuten. Welk programma dat het handigst doet, staat in de vergelijking van statistiekprogramma’s voor je scriptie.
Let er ook op dat dit een andere vraag is dan of je instrument deugt. Of je meting consistent en zuiver is, is een kwestie van betrouwbaarheid en validiteit, en die beoordeel je los van de verdeling van je scores.
Kan ik dit voorkomen bij het opzetten van mijn onderzoek?
Gedeeltelijk, en het scheelt veel gedoe achteraf.
De belangrijkste knop is je steekproefomvang: hoe meer waarnemingen per groep, hoe minder de verdelingsvorm uitmaakt. Hoe je die omvang onderbouwt in plaats van gokt, staat in het stuk over hoeveel respondenten je nodig hebt. De tweede knop is je meetniveau: vraag je naar leeftijd in jaren of in vijf categorieën? Het eerste geeft je een interval-variabele en de volle gereedschapskist, het tweede beperkt je tot rangorde-methoden.
De derde is simpelweg: kijk naar je data zodra de eerste vijftig reacties binnen zijn, niet pas als het veldwerk gesloten is. Een harde afkap of een tweetoppige verdeling is dan nog te repareren met een extra vraag of een gerichte wervingsronde. Of een enquête of interviews hier het geschiktst zijn, is een keuze die je nog eerder maakt — zie hoe je kiest tussen een enquête en een interview.
Wat je opleiding hierover precies verwacht, verschilt: sommige scriptiehandleidingen eisen expliciet een assumptieparagraaf, andere niet. Kijk in je handleiding en op het beoordelingsformulier voordat je er een halve pagina aan besteedt — of juist geen.
Het echte tijdverlies zit meestal niet in de statistiek maar in het opnieuw opschrijven van je methodehoofdstuk nadat je van toets bent gewisseld. Tesify houdt je methode, je resultaten en je conclusie met elkaar in de pas terwijl je schrijft. Schrijf je methodehoofdstuk in Tesify en laat een gewijzigde analyse niet je hele hoofdstuk omgooien.
Veelgestelde vragen
Moet mijn data normaal verdeeld zijn voor een t-toets?
Nee. De aanname gaat over de steekproefverdeling van het gemiddelde, niet over je ruwe waarnemingen. Bij voldoende grote groepen is die vanzelf ongeveer normaal, ook bij scheve data.
Wat is “voldoende groot”?
Er bestaat geen harde grens. Als vuistregel wordt vaak 30 per groep genoemd, maar bij sterk scheve data heb je er meer nodig en bij vrijwel symmetrische data minder. Beschrijf je afweging in plaats van een drempel te citeren.
Mijn Shapiro-Wilk is significant. Mag ik nu geen t-toets doen?
Dat volgt er niet uit. Bij grote steekproeven is die toets vrijwel altijd significant, terwijl de t-toets daar juist het robuustst is. Kijk naar een histogram en een Q-Q-plot en neem op basis daarvan een besluit.
Wat is het non-parametrische alternatief voor een t-toets?
Mann-Whitney U voor twee onafhankelijke groepen en Wilcoxon signed-rank voor twee metingen bij dezelfde personen. Voor drie of meer groepen gebruik je Kruskal-Wallis.
Moet ik uitbijters verwijderen als mijn data scheef zijn?
Alleen als je kunt aantonen dat het meetfouten of invoerfouten zijn. Een echte extreme waarde is data, geen ruis, en die weglaten omdat hij niet uitkomt is niet toegestaan. Rapporteer wat je hebt verwijderd en waarom.
Geldt de normaliteitsaanname ook bij regressie?
Ja, maar voor de residuen, niet voor je variabelen afzonderlijk. Een scheef verdeelde voorspeller is geen probleem zolang de residuen zich netjes gedragen.
Wat doe ik met Likert-data?
Eén losse Likert-vraag is ordinaal; behandel die met rangorde-methoden of rapporteer de mediaan en de verdeling. Een somscore of gemiddelde over meerdere items die samen één begrip meten, wordt in de praktijk vaak wel als interval behandeld.
Wat is het verschil tussen Levene en Shapiro-Wilk?
Levene toetst of groepen dezelfde spreiding hebben, Shapiro-Wilk of een verdeling normaal is. Twee verschillende aannames, twee verschillende oplossingen — de eerste los je meestal op met een Welch-toets.
Moet ik zowel de parametrische als de non-parametrische toets rapporteren?
Het hoeft niet, maar het is sterk als je twijfelt. Komen beide tot dezelfde conclusie, dan is de discussie over de aanname daarmee afgedaan.
Kan ik gewoon transformeren tot het werkt?
Nee. Een transformatie kies je vooraf op inhoudelijke gronden, niet achteraf op basis van welke p-waarde eruit komt. Dat laatste maakt je resultaat oncontroleerbaar.