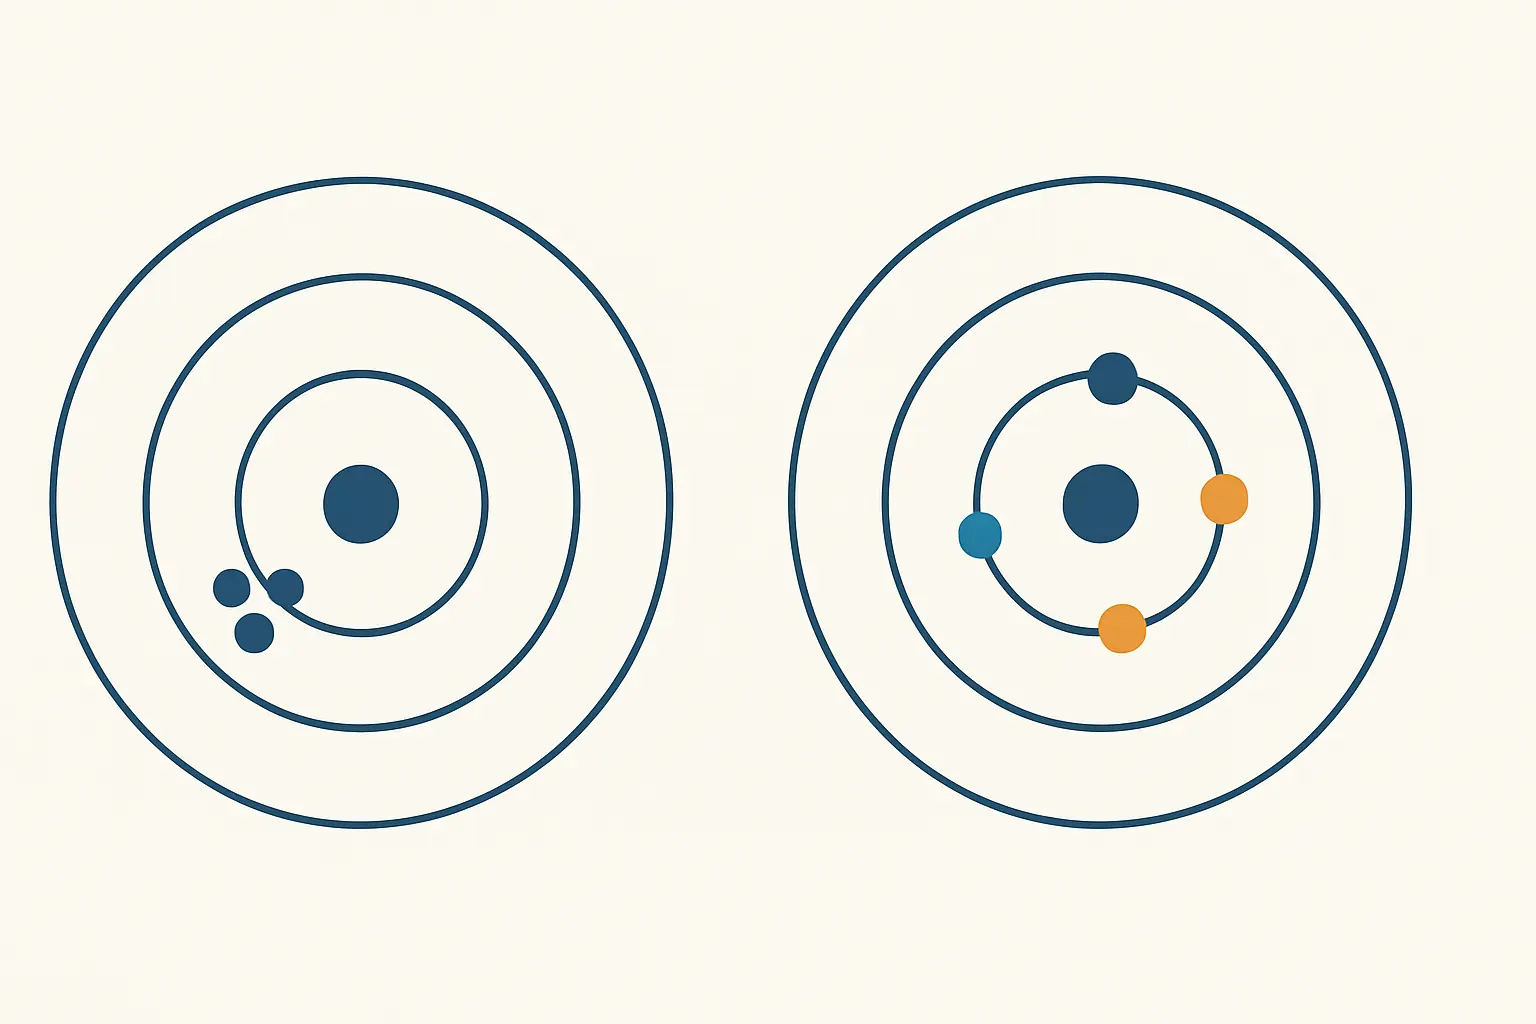
Betrouwbaarheid gaat over consistentie: meet je instrument bij herhaling hetzelfde? Validiteit gaat over raakvlak: meet het wel wat je denkt te meten? Een meting kan perfect betrouwbaar zijn en toch volledig ongeldig — een weegschaal die er structureel drie kilo naast zit, geeft elke dag hetzelfde verkeerde getal.
Die volgorde is niet omkeerbaar: zonder betrouwbaarheid kun je geen validiteit hebben, maar met betrouwbaarheid heb je haar nog niet. Hieronder wat je erover in je methodehoofdstuk zet, wat Cronbachs alfa wel en niet zegt, en welke drempelwaarde je beter niet klakkeloos overneemt. Wat jouw opleiding precies eist, staat in je scriptiehandleiding en in het OER.
Wat betekent betrouwbaarheid precies?
Dat je meting stabiel is. Zou je hem morgen herhalen bij dezelfde mensen onder dezelfde omstandigheden, dan zou er ongeveer hetzelfde uitkomen. De tegenhanger is toevallige ruis: een vraag die verschillend wordt begrepen, een schaal die te vaag is, een respondent die halverwege afhaakt.
In een scriptie kom je drie vormen tegen. Interne consistentie: hangen de items die samen één begrip zouden moeten meten voldoende met elkaar samen? Test-hertestbetrouwbaarheid: geeft dezelfde meting op twee momenten hetzelfde resultaat? Interbeoordelaarsbetrouwbaarheid: komen twee mensen die hetzelfde materiaal beoordelen of coderen tot dezelfde uitkomst?
Voor een enquêtescriptie is de eerste vorm bijna altijd de relevante. Voor een scriptie op interviews is dat de derde.
Wat betekent validiteit precies?
Dat je meet wat je zegt te meten. Dit is een uitspraak over de brug tussen je theoretische begrip en je concrete vragen — dezelfde brug die je in je theoretisch kader slaat als je een concept operationaliseert. Waar die stap precies thuishoort, staat in de gids over het schrijven van een theoretisch kader.
Ook hier drie vormen die in scripties bruikbaar zijn. Inhoudsvaliditeit: dekken je items het hele begrip, of alleen een hoekje ervan? Begripsvaliditeit: gedraagt je meting zich zoals de theorie voorspelt, bijvoorbeeld door samen te hangen met wat ermee zou moeten samenhangen? Externe validiteit: geldt je conclusie ook buiten je eigen steekproef?
Waarom kan iets betrouwbaar zijn maar niet valide?
Omdat consistentie niets zegt over richting. Vraag je vijf keer naar tevredenheid met de kantine en noem je dat “medewerkerstevredenheid”, dan zullen die vijf items prima met elkaar samenhangen: je hebt een betrouwbare schaal. Alleen meet hij de kantine, niet de tevredenheid.
Dit is het punt waarop tweede lezers het vaakst aanslaan, en het is een redeneerfout, geen rekenfout. Een hoge betrouwbaarheidscoëfficiënt kan een ongeldige operationalisering nooit repareren; hij maakt haar hooguit overtuigender op papier.
Is de betrouwbaarheid van je vragenlijst hetzelfde als een betrouwbaarheidsniveau van 95%?
Nee, en die verwarring kost punten. Het betrouwbaarheidsniveau en het bijbehorende betrouwbaarheidsinterval gaan over de precisie van een schatting: hoe zeker je bent dat de werkelijke waarde in de populatie binnen een bepaald bereik ligt. Dat hoort thuis bij je steekproef en je analyse.
De betrouwbaarheid van je meetinstrument gaat over je vragenlijst: geven de items consistent hetzelfde signaal? Dat hoort thuis bij de beschrijving van je instrument. Twee verschillende begrippen, twee verschillende paragrafen, hetzelfde Nederlandse woord. Gebruik in je scriptie consequent “interne consistentie” voor het eerste geval, dan is de verwarring uitgesloten.
Wat is Cronbachs alfa en wat zegt het niet?
Cronbachs alfa is de meest gebruikte maat voor interne consistentie, geïntroduceerd door Lee J. Cronbach in Coefficient Alpha and the Internal Structure of Tests (Psychometrika 16(3), 297–334, DOI: 10.1007/BF02310555). Je berekent hem over een set items die samen één schaal vormen, en hij loopt in de praktijk van 0 tot 1.
Wat hij niet zegt, is minstens zo belangrijk, en daar is de vakliteratuur uitgesproken over. Klaas Sijtsma publiceerde in Psychometrika een artikel met de veelzeggende titel On the Use, the Misuse, and the Very Limited Usefulness of Cronbach’s Alpha (74(1), 107–120, DOI: 10.1007/s11336-008-9101-0), en in hetzelfde nummer verscheen van Green en Yang Commentary on Coefficient Alpha: A Cautionary Tale (74(1), 121–135, DOI: 10.1007/s11336-008-9098-4). Sijtsma kwam er in 2021 met Pfadt op terug in een vervolgartikel (Psychometrika 86(4), 843–860, DOI: 10.1007/s11336-021-09789-8).
Drie praktische consequenties uit die discussie:
- Alfa is geen maat voor eendimensionaliteit. Een schaal die twee verschillende dingen meet, kan een keurige alfa hebben.
- Alfa stijgt met het aantal items. Meer vragen toevoegen verhoogt de waarde, ook zonder dat je meting beter wordt.
- Alfa is geen bewijs van validiteit. Het is een uitspraak over samenhang binnen de set, niet over wat de set meet.
Is 0,70 een harde grens?
Nee. Die waarde circuleert als vuistregel, maar wordt in de literatuur juist bekritiseerd als kritiekloos overgenomen conventie. Keith Taber liet in The Use of Cronbach’s Alpha When Developing and Reporting Research Instruments in Science Education (Research in Science Education 48(6), 1273–1296, DOI: 10.1007/s11165-016-9602-2) zien hoe uiteenlopend auteurs dezelfde alfawaarden beschrijven en hoe los die kwalificaties van elkaar staan.
Praktisch: noem de waarde, noem het aantal items, en interpreteer met terughoudendheid. “De schaal telde zes items en had een Cronbachs alfa van 0,74; dat wijst op een acceptabele interne consistentie voor exploratief onderzoek.” Dat is een verdedigbare zin. “De schaal was betrouwbaar (α = 0,74)” is dat niet, omdat er een oordeel in zit dat het getal niet draagt.
Komt je alfa laag uit, dan is items schrappen tot hij boven een drempel komt de verkeerde reflex. Beschrijf wat je hebt gevonden, kijk of één item inhoudelijk niet bij de rest past, en benoem het als beperking als het probleem blijft.
Hoe onderbouw je dit bij kwalitatief onderzoek?
Daar reken je niets uit, maar de eis blijft. Betrouwbaarheid vertaalt zich naar navolgbaarheid: kan iemand anders jouw stappen herhalen? Dat borg je met een codeboek, met vastgelegde codeerregels en, waar de opleiding dat vraagt, met een tweede codeur die een deel van het materiaal onafhankelijk codeert.
Validiteit vertaalt zich naar geloofwaardigheid: herkennen je respondenten zich in je interpretatie, en heb je tegenvoorbeelden gezocht in plaats van alleen bevestiging? Twee gangbare technieken zijn het terugleggen van je bevindingen bij deelnemers en het expliciet zoeken naar fragmenten die je patroon tegenspreken.
De basis onder beide is een transcript dat klopt; hoe je dat maakt en welke tool daarbij past, staat in de vergelijking van transcriptiesoftware voor je interviews.
Waar schrijf je dit op in je scriptie?
In je methodehoofdstuk, in de paragraaf over je meetinstrument, en niet in je resultaten. Vier zinnen volstaan meestal:
De schaal voor [begrip] bestond uit [aantal] items op een [aantal]-punts Likertschaal, ontleend aan [bron of eigen ontwikkeling]. De interne consistentie is berekend met Cronbachs alfa en kwam uit op [waarde]. De inhoudsvaliditeit is geborgd door de items af te leiden uit [theorie/bron] en voor te leggen aan [pilotgroep/deskundige]. De beperkingen van deze operationalisering zijn beschreven in de discussie.
Rapporteer per schaal, niet één waarde voor de hele vragenlijst: alfa over alle items samen is betekenisloos zodra je meer dan één begrip meet. De berekening zelf is in elk gangbaar pakket een kwestie van een paar klikken; welk pakket bij jou past, staat in het overzicht van statistiekprogramma’s voor je scriptie.
Hoe verhoog je allebei voordat je gaat meten?
- Gebruik een bestaande, gevalideerde schaal als die er is, en citeer de bron. Zelf items bedenken is de belangrijkste bron van validiteitsproblemen in scripties.
- Vertaal niet losjes. Een Engelse schaal die je zelf vertaalt, is niet meer dezelfde gevalideerde schaal; zeg dat er dan bij.
- Test op vijf tot tien mensen uit je doelgroep en vraag wat ze bij elke vraag dachten. Dit haalt dubbelzinnige items eruit voordat ze schade doen.
- Meet één begrip per schaal en houd de schalen uit elkaar in je vragenlijst.
- Let op de instellingen van je enquêtetool: verplichte vragen, een consistente schaalrichting en een voortgangsbalk beperken ruis. De verschillen per tool staan in de vergelijking van enquêtetools voor je scriptie.
Deze twee begrippen lopen door je hele scriptie heen: je operationalisering staat in hoofdstuk 2, je onderbouwing in hoofdstuk 3, en je beperkingen in de discussie. Tesify bewaakt precies die doorwerking — of je begrippen tussen hoofdstukken gelijk blijven en of een wijziging in je instrument ook in je verantwoording is doorgevoerd. Schrijf je methodehoofdstuk in Tesify.
Veelgestelde vragen
Wat is het verschil tussen betrouwbaarheid en validiteit?
Betrouwbaarheid is consistentie: je meting geeft bij herhaling hetzelfde resultaat. Validiteit is raakvlak: je meet werkelijk het begrip dat je zegt te meten. Betrouwbaarheid is een voorwaarde voor validiteit, geen bewijs ervan.
Kan een meting valide zijn zonder betrouwbaar te zijn?
Niet in praktische zin. Als je uitkomsten willekeurig schommelen, kun je geen enkele uitspraak onderbouwen. Daarom controleer je eerst de consistentie en pas daarna de vraag of je het juiste meet.
Welke alfawaarde is goed genoeg?
Er bestaat geen harde grens. De veelgenoemde 0,70 is een vuistregel die in de literatuur juist wordt bekritiseerd. Rapporteer de waarde met het aantal items erbij en beschrijf haar in voorzichtige bewoordingen.
Mag je items verwijderen om je alfa te verhogen?
Alleen als daar een inhoudelijke reden voor is, en je vermeldt het altijd. Items schrappen tot een getal een drempel haalt, is datamanipulatie en niet moeilijk te herkennen.
Moet je Cronbachs alfa per schaal of over de hele vragenlijst berekenen?
Per schaal. Alfa is gedefinieerd voor een set items die samen één begrip meet; over verschillende begrippen samen is de waarde betekenisloos.
Hoe onderbouw je betrouwbaarheid bij interviews?
Met navolgbaarheid: een codeboek, vastgelegde codeerregels en waar mogelijk een tweede codeur die een deel van het materiaal onafhankelijk codeert. Er is geen coëfficiënt die je hier verplicht moet rapporteren.
Is een grotere steekproef betrouwbaarder?
Een grotere steekproef maakt je schattingen preciezer, maar verandert niets aan de betrouwbaarheid van je meetinstrument. Dat zijn twee verschillende dingen die in het Nederlands ongelukkig hetzelfde heten.
Waar in mijn scriptie hoort dit?
In het methodehoofdstuk, in de paragraaf over je meetinstrument. De consequenties voor je conclusie beschrijf je in de discussie, bij de beperkingen.
Moet ik een gevalideerde schaal gebruiken?
Als er een bestaat voor jouw begrip: ja, en citeer de bron. Zelf items ontwerpen mag, maar dan moet je de inhoudsvaliditeit expliciet onderbouwen en de beperking benoemen.
Wat doe ik als mijn alfa laag uitvalt?
Rapporteer de waarde, kijk of één item inhoudelijk afwijkt van de rest, en benoem het als beperking in je discussie. Een lage alfa met een eerlijke bespreking weegt zwaarder dan een opgepoetste waarde.
Verschillen de eisen per opleiding?
Ja. Sommige opleidingen vragen expliciet om een betrouwbaarheidsanalyse, andere niet. Kijk in je scriptiehandleiding en op het beoordelingsformulier welke criteria bij jou worden aangevinkt.